
Как выбрать способ
Речь внутри видеомодели подходит, когда нужен цельный короткий кадр с говорящим персонажем, действиями и атмосферой. Вы описываете сцену и фразу в одном запросе, а затем проверяете и изображение, и звук. Модель может изменить слова, произношение или синхронизацию губ; один и тот же запрос не гарантирует одинаковый результат. Отдельная озвучка удобна, когда видео уже готово и нужно отдельно управлять текстом, голосом и моментом начала фразы. Она не заставляет персонажа автоматически шевелить губами: для говорящего крупного плана может потребоваться отдельная синхронизация. Ниже показаны настройки ElevenLabs без запуска новой аудиогенерации.
Способ 1. Создайте видео с речью в MiniMax H3
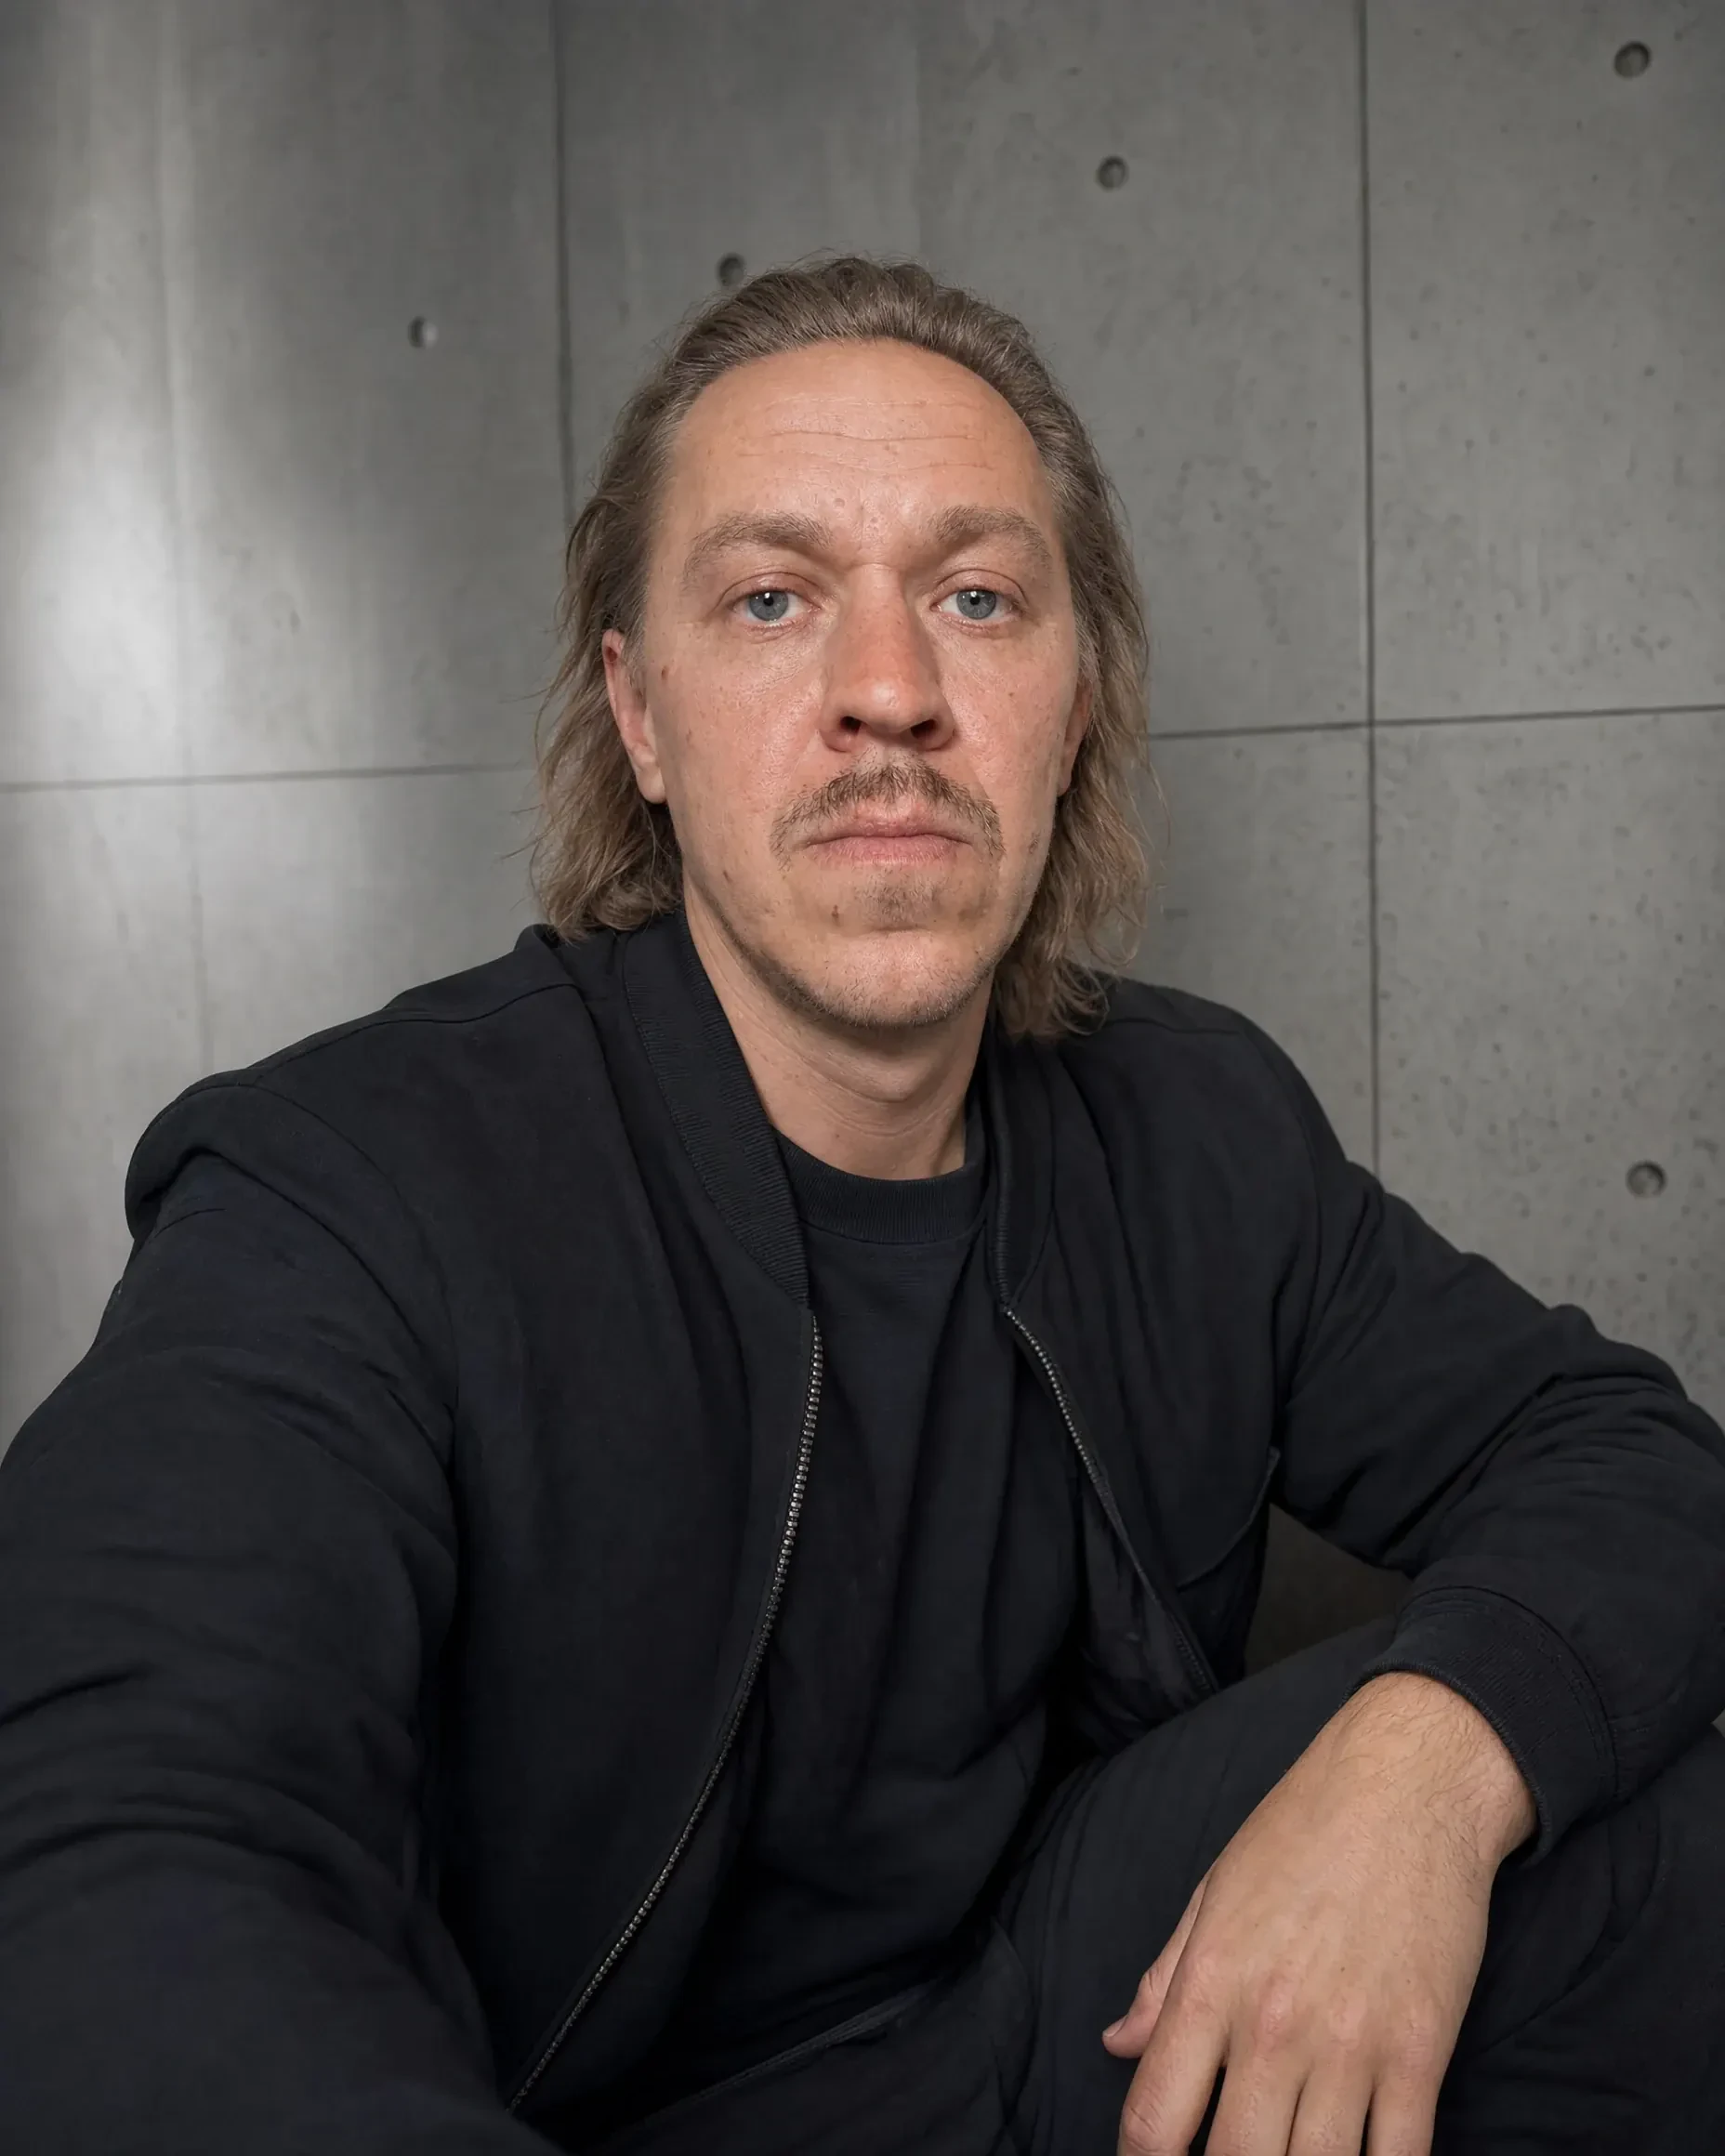
Мы взяли опубликованный в библиотеке промптов портрет персонажа в чёрной одежде и запустили MiniMax H3 через ИИшку. Выбрали «Видео» → MiniMax H3 → «Референсы → видео», загрузили портрет и ввели один короткий запрос. Настройки запуска: 9:16, 480p, 5 секунд. Кнопка показывала 9 алмазов 5 ноября 2026 года. Цена и доступность могут измениться: проверьте их до запуска. Фактический запрос: Мужчина с референса сидит в кадре и смотрит прямо в камеру. Он спокойно и дружелюбно произносит по-русски: «Привет! Идеи становятся реальностью». Естественная мимика и синхронное движение губ, один непрерывный план, камера неподвижна. Без музыки, субтитров и надписей. Ролик сформирован: его длительность — 5,17 секунды, файл содержит звуковую дорожку. Точность произнесённой фразы и синхронизацию губ в этом примере необходимо оценить при просмотре с включённым звуком. Чтобы повторить: загрузите изображение, на которое у вас есть права; выберите поддерживающую звук видеомодель и доступный режим с референсом; укажите действие, точную фразу, язык, манеру речи и желаемые фоновые звуки. Перед запуском проверьте длительность и цену. После получения результата сравните произнесённые слова с текстом, посмотрите на губы, черты лица и руки; проверьте ролик с включённым звуком до последней секунды.
Пятисекундный ролик по портрету из библиотеки промптов ИИшки
Способ 2. Настройте ElevenLabs и добавьте отдельный звук
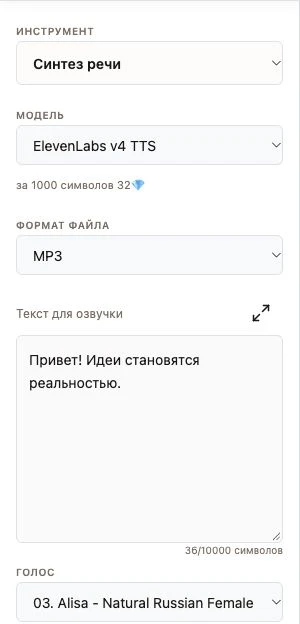
Откройте «Аудио» → «Синтез речи». В поле текста можно ввести, например, «Привет! Идеи становятся реальностью». На подготовленном скриншоте выбраны ElevenLabs v4 TTS, формат MP3 и голос Alisa; на 5 ноября кнопка для этого текста показывала 32 алмаза. Скриншот показывает настройки перед запуском: по просьбе пользователя новая аудиодорожка не создавалась. Реальное произношение и длительность этого текста мы здесь не проверяли. После самостоятельной генерации скачайте аудиофайл, откройте готовое видео и звук в видеоредакторе и разместите дорожку под роликом. Сдвиньте её начало на нужный кадр и проверьте, чтобы последнее слово не обрывалось. Если голос длиннее ролика, сократите текст или удлините видеоряд. Если уже есть музыка или оригинальная речь, отрегулируйте их громкость и проверьте, не мешают ли они диктору. Экспортируйте копию и прослушайте на телефоне. Для воспроизведения без звука добавьте проверенные субтитры.
Что делать, если результат не подходит
Если модель произнесла не ту фразу, сократите реплику и прямо выделите её в запросе; повторный запуск оплачивается по действующей цене. Если речь понятна, но губы не совпадают, попробуйте другой кадр или инструмент синхронизации. Если в отдельной дорожке неверное ударение, исправьте написание и прослушайте новую пробу. Если в начале или конце слышен обрыв, оставьте запас времени на монтажной шкале. Не клонируйте чужой голос и не используйте чужое изображение без необходимых прав и согласия.
Перед публикацией
Проверьте точность слов и ударений, громкость, отсутствие обрывов и права на исходное изображение, видео, голос и музыку. Для чувствительных утверждений о товаре проверяйте текст по подтверждённым данным. Подробные аудиопримеры и разбор ударений есть в статье /blog/elevenlabs-udareniya-audio-tegi; технические приёмы для MiniMax — в /blog/minimax-h3-rukovodstvo-po-promptam.